Server-side tracking: wanneer heb je het nodig en wanneer niet?
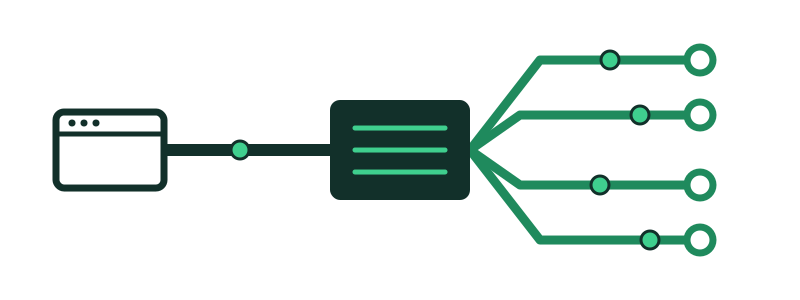
Server-side tracking wordt steeds vaker genoemd als oplossing voor betere datakwaliteit, privacy en een toekomstbestendige analytics-infrastructuur. Maar server-side tracking is geen wondermiddel.
Een server-side implementatie kan een waardevolle verbetering zijn, maar alleen als de onderliggende meting goed is ingericht. Is je huidige tracking onduidelijk of onbetrouwbaar, dan verplaats je met server-side tracking vooral het probleem. En het brengt ook kosten, onderhoud en nieuwe verantwoordelijkheden met zich mee.
In dit artikel leg ik uit wat server-side tracking is, wat het kan opleveren en wanneer het zinvol is om erin te investeren.
Wat is server-side tracking?
Bij traditionele client-side tracking stuurt de browser van de bezoeker trackingrequests rechtstreeks naar elk platform afzonderlijk:
Bij server-side tracking verplaats je een deel van die verwerking naar een serveromgeving die je zelf beheert: een server-side tag manager, zoals GTM server-side of Tealium EventStream. De browser stuurt de data één keer naar jouw eigen endpoint, en daar bepaal jij wat er naar welke bestemming gaat:
Tealium EventStream
Je komt het ook tegen als server-side tagging. In Google Tag Manager heet de serveromgeving een server container, vaak afgekort als sGTM. Bij Tealium heet de server-side oplossing EventStream.
Waarom zou je server-side tracking gebruiken?
1. Meer controle over datastromen
Gaat tracking rechtstreeks vanuit de browser naar allerlei externe partijen, dan is het lastig om centraal te bepalen welke informatie wordt gedeeld. Met een server-side architectuur krijg je meer controle over:
- welke data wordt doorgestuurd;
- naar welke systemen;
- welke parameters worden meegestuurd;
- welke informatie wordt verwijderd, gefilterd of gepseudonimiseerd voordat die een derde partij bereikt.
2. Minder werk in de browser
Bij client-side tracking doet de browser relatief veel werk: voor elke tool een eigen script en eigen requests. Server-side tracking verplaatst een deel daarvan naar een gecontroleerde omgeving. Eén keer verzamelen, meerdere keren distribueren. Afhankelijk van de implementatie levert dat voordelen op voor performance, onderhoudbaarheid en controle.
3. Verrijking en integratie van meerdere databronnen
Een server-side omgeving wordt extra interessant als je meting niet alleen uit website-events bestaat. Je kunt data verrijken met gegevens die je niet in de browser wilt tonen, zoals winst per product, klanttype of orderstatus. Hoe dat in de praktijk werkt, lees je in de case sturen op marge met server-side tracking. En ook de backend of het CRM kan events aanleveren:
Daarmee wordt server-side tracking onderdeel van een bredere data-architectuur.
Cookies, adblockers en conversie-API's
Drie onderwerpen komen bijna altijd voorbij als het over server-side tracking gaat. Ze zijn vaak de eigenlijke aanleiding, maar vragen allemaal om nuance.
First-party cookies en Safari
Safari beperkt cookies die via JavaScript in de browser worden gezet tot maximaal zeven dagen. Een server-side tag manager op een eigen subdomein kan cookies via de server zetten, en die blijven in principe langer geldig. Daardoor worden terugkerende bezoekers en conversies beter aan elkaar gekoppeld.
Maar let op: sinds Safari 16.4 geldt dezelfde beperking ook voor cookies die de server zet, als het endpoint op een heel ander IP-adres draait dan je website. Dat is bijvoorbeeld het geval bij een subdomein dat via een CNAME naar een externe hostingpartij verwijst. Hoeveel je wint, hangt dus sterk af van de technische inrichting.
Adblockers
Requests naar je eigen domein worden minder vaak geblokkeerd dan requests naar bekende trackingdomeinen. Dat maakt je data completer. Het is alleen geen reden om de keuze van bezoekers te omzeilen: wie geen toestemming geeft, meet je ook server-side niet. Daarover hieronder meer.
Conversie-API's voor advertentieplatformen
Advertentieplatformen bieden steeds vaker een directe server-to-server-koppeling, zoals de Meta Conversions API, enhanced conversions voor Google Ads en vergelijkbare API's van TikTok en LinkedIn. Een server-side tag manager is de gebruikelijke manier om die te voeden, vaak met extra context uit de backend.
Stuur je hetzelfde event zowel vanuit de browser als vanuit de server, zorg dan voor deduplicatie met een gedeelde event-ID. Anders telt het platform je conversies dubbel.
Maar server-side tracking lost slechte data niet op
Dit is het belangrijkste punt. Stel dat je website een aankoop twee keer meet. Stuur je die twee requests via een server-side omgeving naar GA4, dan heb je nog steeds twee aankopen. De architectuur is veranderd, de meting niet. Server-side maakt slechte data vooral sneller.
Daarom begin ik altijd in deze volgorde:
- Wat meten we?
- Hoe verzamelen we die data?
- En pas daarna: waar moet de verwerking plaatsvinden?
Wanneer is server-side tracking interessant?
Server-side tracking kan waardevol zijn als je organisatie bijvoorbeeld:
- al een volwassen, betrouwbare meetoplossing heeft;
- meerdere marketing- en dataplatformen gebruikt;
- meer controle over datastromen nodig heeft;
- complexe consent- en privacyvraagstukken heeft;
- website- en backenddata wil combineren;
- conversiedata betrouwbaarder naar advertentieplatformen wil sturen;
- een grotere, toekomstbestendige meetarchitectuur nodig heeft.
Het is dus vooral interessant als er een concreet architectuurprobleem moet worden opgelost, en er iemand is die de omgeving beheert en bewaakt.
Wanneer zou ik er niet mee beginnen?
Bij een organisatie met:
- een relatief eenvoudige website en beperkte meetbehoefte;
- weinig marketingintegraties;
- een onduidelijk eventmodel of slechte documentatie;
- veel bestaande trackingproblemen;
- geen eigenaar voor beheer en monitoring van de serveromgeving;
- een business case die vooral neerkomt op "het is een trend";
is server-side tracking waarschijnlijk niet het eerste wat moet worden opgelost. Dan begin ik liever met de basis:
Pas als die basis op orde is, kun je goed beoordelen of een server-side architectuur iets toevoegt. Een goed ontworpen, toolonafhankelijke datalaag is daarbij het fundament. Twijfel je aan de kwaliteit van je huidige data, lees dan eerst waarom je GA4-data niet klopt.
Wat kost server-side tracking?
De kosten bestaan uit hosting, implementatie en beheer. Hosting voor GTM server-side begint gratis (tot 10.000 requests per maand) en loopt bij de standaardpakketten van TAGGRS en Stape op tot zo'n € 130–200 per maand bij miljoenen requests. Bij Tealium EventStream zit de hosting in je Tealium-licentie.
In alle gevallen hangen de kosten af van het aantal requests. Een goed meetplan met duidelijke requirements kan dat aantal, en dus de kosten, aanzienlijk verminderen, zoals in deze case bij een grote organisatie. In wat kost server-side tracking? zet ik alle kostenposten, hostingopties en een rekenvoorbeeld op een rij.
Server-side tracking is geen privacy-oplossing op zichzelf
Dat een request via je eigen server loopt, betekent niet dat je privacyvraagstukken zijn opgelost. Je moet nog steeds bepalen:
- welke data je verzamelt, en op basis van welke grondslag;
- wanneer data mag worden verwerkt;
- welke partijen de data ontvangen;
- hoe consent wordt toegepast;
- welke gegevens je bewaart, en hoe lang.
Let op consent: server-side tracking is geen omweg rond toestemming. Je blijft verplicht consent te respecteren, ook als de data via jouw eigen server loopt. Server-side kan je meer technische controle geven, maar privacy by design begint bij de meting zelf.
Een goede server-side architectuur begint bij de datastroom
Voordat je een server-side tag manager implementeert, werk ik eerst de volledige datastroom uit. Bijvoorbeeld:
Per stap wil je weten:
- welke data wordt verzameld;
- welke data wordt toegevoegd;
- welke data wordt verwijderd;
- wie verantwoordelijk is;
- welke systemen de data ontvangen.
Zo wordt de architectuur bespreekbaar voor marketing, development, data én privacy.
Wat betekent dit voor bureaus?
Voor bureaus kan server-side tracking een lastig onderwerp zijn. Klanten verwachten soms dat het bureau "iets met server-side" gaat doen, terwijl nog niet duidelijk is welk probleem ermee moet worden opgelost.
Een goede technische aanpak begint daarom niet met "we moeten GTM server-side implementeren", maar met "welk probleem proberen we hiermee op te lossen?" Dat kan datakwaliteit zijn, controle over datastromen, architectuur, privacy of integratie. Van daaruit bepaal je of server-side tracking inderdaad de juiste oplossing is. Zo kan ik bureaus helpen.
Een praktische aanpak
Beoordeel ik een server-side vraagstuk, dan volg ik grofweg deze stappen:
- Begrijp de huidige meting: welke events worden verzameld en waar komen ze vandaan?
- Breng de datastromen in kaart: welke informatie gaat naar welke systemen?
- Controleer consent en privacy: welke data mag wanneer waar naartoe?
- Bepaal de technische knelpunten: waar zit de beperking écht?
- Ontwerp de gewenste architectuur: welke verantwoordelijkheden horen bij de browser, de server en de systemen daarna?
- Bepaal of server-side nodig is: soms is het antwoord ja, soms is een betere client-side implementatie voldoende.
Conclusie
Server-side tracking kan een belangrijke bouwsteen zijn van een moderne meetarchitectuur. Maar het is geen eerste stap en geen doel op zich. De belangrijkste vraag is niet "moeten we server-side tracking implementeren?", maar "welke meetuitdaging proberen we op te lossen, en welke architectuur past daar het beste bij?"
Een goede technische oplossing begint bij de meetbehoefte en eindigt bij een betrouwbare datastroom. Een Tracking Blueprint helpt om die keuzes vooraf te onderbouwen.
Hulp nodig bij je meting?
Bespreek vrijblijvend wat ik voor je kan betekenen.
Liever eerst iemand laten meekijken? Plan een meekijksessie van een uur voor €195 excl. btw.
WhatsApp Neem contact op